网站导航

AI 产品
排行榜分类
其他AI

LLaMA-Factory Online

无代码LLM微调平台

价格以官网为准编辑评分 未评分
访问官网 ↗

产品与联系信息

使用平台
网页版
语言支持
未注明
资料更新
2026-11-03
www.llamafactory.com.cn
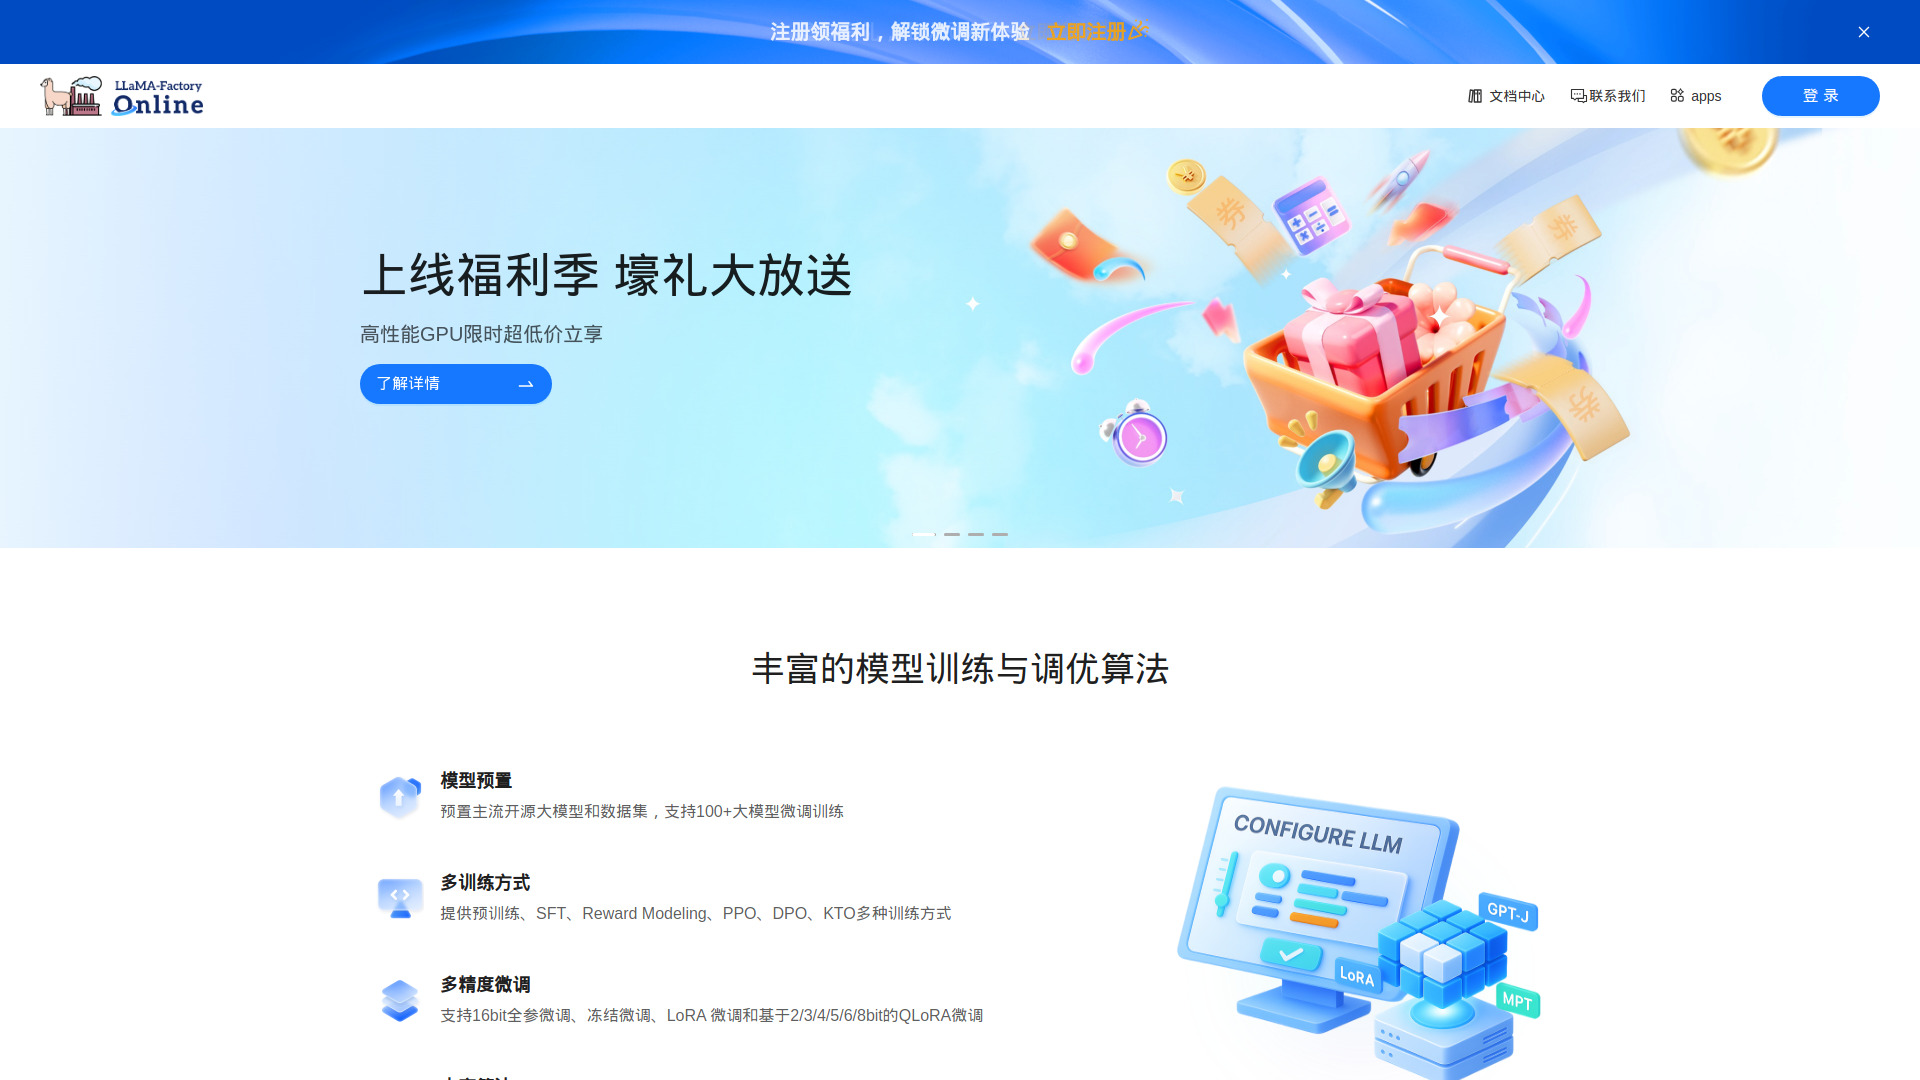
LLaMA-Factory Online 产品截图查看大图 ↗
LLaMA-Factory Online 产品截图图片来源 ↗产品页面预览

核心能力

6 项
  • 丰富的模型库(100+模型):选择超过100种主流开源模型,包括LLaMA、Qwen、DeepSeek、GPT-OSS等。
  • 全面的训练方法:支持整个训练生命周期:预训练、SFT(监督微调)、奖励建模,以及如PPO、DPO和KTO等对齐技术。
  • 灵活的精度与量化:根据资源需求定制使用,支持16位全微调、冻结微调、LoRA和QLoRA(支持2/3/4/5/6/8位量化)。
展开全部 6 项
  • 丰富的模型库(100+模型):选择超过100种主流开源模型,包括LLaMA、Qwen、DeepSeek、GPT-OSS等。
  • 全面的训练方法:支持整个训练生命周期:预训练、SFT(监督微调)、奖励建模,以及如PPO、DPO和KTO等对齐技术。
  • 灵活的精度与量化:根据资源需求定制使用,支持16位全微调、冻结微调、LoRA和QLoRA(支持2/3/4/5/6/8位量化)。
  • 前沿的优化算法:通过集成的最先进优化技术(如GaLore、BAdam、LoRA+、PiSSA、DoRA和rsLoRA)保持领先。
  • 强大的实验跟踪:实时监控训练,内建支持LlamaBoard、TensorBoard、WandB、MLflow和SwanLab。
  • 高效加速:使用FlashAttention-2和Unsloth加速操作,以支持Transformers和vLLM推理引擎最大化速度。

典型使用场景

6 项
  • 基于Qwen3-vl-30B-A3B-Instruct的自动化中文作文评分器,用于智能评分和反馈。
  • 专门化的AI票务助手,成为由Qwen2.5-14B-Instruct驱动的定制客户服务代理。
  • 低成本的巨型MoE模型微调,使用KTransformers优化高效微调DeepSeek-V3。
展开全部 6 项
  • 基于Qwen3-vl-30B-A3B-Instruct的自动化中文作文评分器,用于智能评分和反馈。
  • 专门化的AI票务助手,成为由Qwen2.5-14B-Instruct驱动的定制客户服务代理。
  • 低成本的巨型MoE模型微调,使用KTransformers优化高效微调DeepSeek-V3。
  • 医学影像分析,基于Qwen3-vl-30B-A3B-Instruct的医疗诊断微调案例。
  • 轻量智能家居模型,部署在Qwen3-4B上以实现高效、基于边缘的家居自动化控制。
  • 法律AI助手,构建于LightLLM和LlamaIndex的专业法律助手。

快速上手

1 项
  • 快速上手

    三步轻松开始微调:

    1. 准备数据与模型:通过SFTP或其他支持的方法将数据集无缝上传到平台。

    2. 配置与启动:选择基础模型并在我们的可视化界面中配置关键参数。选择快速模式以快速开始,或选择专家模式以进行深入定制。选择符合您预算和时间安排的定价方案,然后一键启动任务。

    3. 监控与评估:使用LlamaBoard和TensorBoard等内建工具实时追踪训练损失和资源使用情况。完成后,使用模型评估量化结果,或通过模型聊天功能即时验证性能。

查看完整说明
  • 快速上手

    三步轻松开始微调:

    1. 准备数据与模型:通过SFTP或其他支持的方法将数据集无缝上传到平台。

    2. 配置与启动:选择基础模型并在我们的可视化界面中配置关键参数。选择快速模式以快速开始,或选择专家模式以进行深入定制。选择符合您预算和时间安排的定价方案,然后一键启动任务。

    3. 监控与评估:使用LlamaBoard和TensorBoard等内建工具实时追踪训练损失和资源使用情况。完成后,使用模型评估量化结果,或通过模型聊天功能即时验证性能。

工具详细介绍进一步了解 LLaMA-Factory Online 的产品定位与使用说明展开阅读收起介绍

LLaMA-Factory Online是官方的云端LLM训练和微调平台,与著名的开源项目LLaMA-Factory合作开发。

我们致力于为寻求简化微调过程或拥有有限工程资源的用户提供一套开箱即用、低代码及端到端的解决方案。

适合人群

  • 构建AI能力的团队
  • 有微调需求的用户
  • 具备基本编码与工程能力的用户
  • 工程师
  • 研究人员
  • AI开发者

产品优势

  • 与LLaMA-Factory开源项目的官方合作。
  • 提供高性能和弹性的GPU资源(例如:H800A)。
  • 提供开箱即用、低代码的一站式微调服务。
  • 支持超过100种主流开源模型和数据集。
  • 包含多种训练方法(SFT、PPO、DPO、KTO)和微调精度(16位、LoRA、QLoRA)。
  • 集成丰富的优化算法,例如GaLore、BAdam和PiSSA。
  • 提供可视化参数配置UI,零代码模型生成。
  • 支持分布式训练,满足可扩展性。
  • 覆盖从数据准备到模型对话的完整模型生产工作流。
  • GPU加速和秒级计费,具备性价比与灵活性。
  • 提供新用户福利、优惠券及促销折扣。
  • 提供专门的客户支持和社区协助。

使用注意

  • 提供的内容中没有明显的缺点。
产品表现洞察

LLaMA-Factory Online 数据分析

官网访问趋势、地区分布与流量渠道

更新于 2026-11-03

最新流量情况

月访问量 (2026-09)
暂无数据
平均访问时长
00:00:00
每次访问页数
0.00
跳出率
0.00%

访问量采用最近明确月份的曲线值;其余指标按概览区间展示。

2025-09 - 2026-09 全部流量

访客国家与地区

0 个地区

来源未标注统计范围

暂无公开地区数据

流量来源渠道

0 个渠道

来源未标注统计范围

暂无公开渠道数据

热门搜索关键词

公开搜索表现
关键词 流量 点击费用
llamafactory 暂无数据 暂无数据
llama-factory 暂无数据 暂无数据
llama factory 暂无数据 $ 0.99
lama factory 暂无数据 暂无数据

常见问题

3 个问题
如果微调结果不理想,我该如何提高模型性能?

1. 扩展数据集:增加训练数据集的大小。 2. 增加训练时长:设置更高的训练周期(例如:num_train_epochs: 5.0),或增加总步数(例如:max_steps: 1000)。 3. 调整学习率:尝试增加学习率(例如:将learning_rate设置为2.0e-4)。 4. 切换微调方法:尝试不同的微调类型,如冻结(冻结参数)或全参数调优,通过finetuning_type设置。

如何解决训练期间的"CUDA内存不足"(OOM)错误?

如果您遇到GPU内存不足的问题,请尝试以下优化策略: 1. 减小批量大小:将per_device_train_batch_size设置为1。 2. 优化运算符:通过将enable_liger_kernel设置为true和use_unsloth_gc设置为true启用内存高效的内核。 3. 缩短序列长度:减小cutoff_len(例如:设置为512)。 4. 使用高级并行:启用DeepSpeed ZeRO-3或FSDP以在设备之间分片模型权重,或启用CPU卸载。 5. 应用量化:将quantization_bit设置为4以压缩模型参数(仅适用于LoRA微调)。

如何修复模型输出无意义或重复的情况?

解决方案取决于问题发生的时间: 如果在训练之前发生:这通常是由于使用原始基础模型(未对齐)或错误的提示模板造成的。请确保您使用的是对齐的指令/聊天模型和正确的模板。 如果在训练之后发生: 模板一致性:验证用于推理的模板与训练期间的模板是否一致。 检查过拟合:如果模型过拟合,请尝试减少训练周期(num_train_epochs)和降低学习率(learning_rate)。

评论与评分

总评分
请选择

正在载入评论…

真实会员评论,审核通过后公开展示。回复不重复计入评分。

探索更多相关工具

更多同类工具

AI提示词

Snack Prompt

★ 4.0

适合发现热门 Prompt、收藏模板和分享经验。

提示词发现社区了解详情 →
模型AI

Hugging Face

★ 4.5

模型、数据集和应用社区最丰富的平台之一。

模型与社区平台了解详情 →
视频AI

Runway

★ 4.5

适合视频生成、编辑、特效和创意短片制作。

AI 视频创作平台了解详情 →
对话AI

Perplexity

★ 4.6

以搜索为核心的 AI 答案引擎,适合资料查找与调研。

搜索问答助手了解详情 →

安全验证

请完成验证后继续操作。